 Gitsels Data
Slowly Changing Dimensions (SCD)
Wat Slowly Changing Dimensions zijn, en hoe je het implementeert.
Stel je voor: een klant verhuist van Eindhoven naar Rotterdam. In je brondata wordt het adresveld gewoon overschreven — logisch, want dat ís nu het huidige adres. Maar een paar weken later wil de organisatie weten hoeveel omzet er afgelopen jaar vanuit de regio Eindhoven kwam. Als je alleen het huidige adres bijhoudt, is dat antwoord niet meer zuiver op te halen. De historie is overschreven en daarmee ook verdwenen.
Dit is waar we Slowly Changing Dimensions (SCD) voor hebben: hoe ga je om met veranderende attributen in je tabellen, zonder de historische waarheid kwijt te raken?
De belangrijkste SCD-types
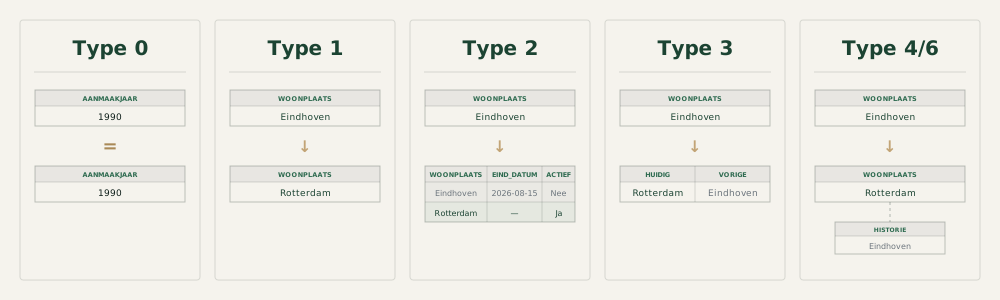
- Type 0 — Vaste waarde. Het attribuut verandert nooit, of wijzigingen worden bewust genegeerd. Denk aan een geboortedatum of een oorspronkelijk aanmaakjaar. Hiervoor zou geen historie of aanpassing nodig moeten zijn.
- Type 1 — Overschrijven. De oude waarde wordt simpelweg vervangen door de nieuwe. Snel en simpel, maar je verliest wel historie. Geschikt voor correcties van foutieve data, niet voor echte wijzigingen die je wilt bijhouden en terugzien.
- Type 2 — Nieuwe rij toevoegen. Bij een wijziging voeg je een nieuwe rij toe en markeer je de oude rij als verouderd, meestal met een aantal metadata vlaggen zoals
Start_Datum,Eind_DatumenIs_Actief. - Type 3 — Extra kolom. Je voegt een kolom toe zoals
Vorige_Waarde, zodat je alleen de vorige waarde bewaart, niet de volledige historie. Handig als je maar één stap terug hoeft te kunnen kijken. - Type 4/6 — Hybride varianten. Combinaties van bovenstaande, bijvoorbeeld een aparte historietabel of een mix van overschrijven en rijen toevoegen binnen dezelfde tabel.
In de praktijk is Type 2 verreweg de meest gebruikte variant zodra historie er echt toe doet — en dat is meteen waar de implementatie interessant wordt, want een Lakehouse en een Warehouse pakken dit fundamenteel anders aan.
SCD Type 1 implementeren
Type 1 is de simpelste vorm — overschrijven — en dat is ook in de implementatie terug te zien:
- Directe UPDATE of UPSERT. In een Warehouse volstaat vaak een simpele
UPDATE, of eenMERGEdie alleenUPDATEenINSERTbevat (geen "sluit de oude rij af"-logica). In een Lakehouse is dat het Delta Lake-equivalent:MERGE INTO ... WHEN MATCHED THEN UPDATE ... WHEN NOT MATCHED THEN INSERT. - Dataflow Gen2 in Fabric. Voor een low-code aanpak biedt Fabric een kant-en-klaar patroon: je vergelijkt nieuwe rijen met de bestaande, bijvoorbeeld via een Merge-operatie in Power Query, en overschrijft de rijen die zijn gewijzigd.
- Copy Job CDC (Merge-methode). Haal je incrementele data op via Change Data Capture in een Fabric Copy Job? Dan is "Merge" de standaardmethode: inserts worden toegevoegd, updates overschrijven de bestaande rij, deletes worden verwijderd. Dit is in feite kant-en-klare SCD Type 1, zonder dat je er zelf iets voor hoeft te bouwen.
SCD Type 2 implementeren
Bij Type 2 wordt het wat complexer, omdat je niet alleen wijzigingen moet detecteren, maar ook oude rijen moet afsluiten én nieuwe moet toevoegen met de correcte Start_Datum en Eind_Datum. Een paar manieren om dit te doen:
- Handmatige MERGE (T-SQL of Spark SQL). De klassieke aanpak: een
MERGE-statement (of twee losseUPDATE/INSERT-stappen) dat bestaande rijen als "oud" markeert en nieuwe rijen toevoegt als "nieuw". Dit werkt zowel in een Fabric Warehouse (via een stored procedure) als in een Lakehouse-notebook (via PySpark of Spark SQL). Je hebt hier volledige controle, maar bouwt zelf de logica voor changedetectie, keys en datumvelden. - Dataflow Gen2 en Copy Job in Fabric. Ook voor Type 2 werkt Microsoft aan low-code oplossingen via Dataflow Gen2 en Fabric Copy Jobs — voor de Dataflow Gen2-route zijn inmiddels een aantal tutorials beschikbaar. Op het moment van schrijven zijn de connectiemogelijkheden voor Copy Jobs echter nog zeer beperkt. Je definieert welke kolommen als key dienen, waarna je job automatisch controleert of er verschillen zijn in de overige kolommen en of dit tot een update moet leiden. Handig als je low-code wilt blijven, maar toch historie nodig hebt.
- Databricks AUTO CDC (voorheen APPLY CHANGES INTO). Binnen Databricks Lakeflow-pipelines kun je met
AUTO CDChet grootste deel van het handwerk overslaan: je geeft een sleutel, een sequencing-kolom enSTORED AS SCD TYPE 2op, en Databricks regelt zelf de afhandeling van de historie en de start/eind-metadatakolommen. Dit is de meest gestroomlijnde route voor SCD2-implementaties als je met Databricks werkt.
Welke implementatie past bij jou?
- Weinig wijzigingen, veel controle nodig? Een handmatige
MERGEin T-SQL of Spark SQL geeft je de meeste flexibiliteit, tegen de prijs van meer onderhoud. - Low-code team, al bekend met Power BI? Dataflow Gen2 in Fabric is een prima startpunt, zonder dat je te veel code hoeft te schrijven.
- Veel CDC-feeds uit bronsystemen, en al op Databricks?
AUTO CDCbespaart flink wat implementatietijd, zeker bij meerdere dimensietabellen die dezelfde opzet nodig hebben. - CDC direct uit de bron, zonder transformatiebehoefte? De Merge-methode in een Fabric Copy Job geeft je Type 1-gedrag zonder dat je zelf iets hoeft te bouwen — een mooie optie wanneer je de huidige data makkelijk wilt ontsluiten zonder veel rompslomp eromheen.
Welke route je ook kiest: de onderliggende logica blijft hetzelfde. Het verschil zit in hoeveel je zelf handmatig opbouwt, en hoeveel het platform al voor je regelt.
Kortom
SCD-types bepalen hoe je omgaat met veranderende data in je tabellen, en Type 2 is de standaard zodra historie belangrijk wordt. Hoe je dat implementeert hangt vooral af van je platform en je team: een handmatige MERGE in T-SQL of Spark SQL, een low-code Dataflow Gen2-patroon in Fabric, of een grotendeels geautomatiseerde aanpak zoals Databricks' AUTO CDC. Het principe blijft steeds hetzelfde — het verschil zit in hoeveel je zelf bouwt en hoeveel controle je wilt houden over het proces.
Wil je hulp bij het opzetten van een SCD-strategie in jouw Lakehouse of Warehouse? Neem gerust contact op.